内核同步方法
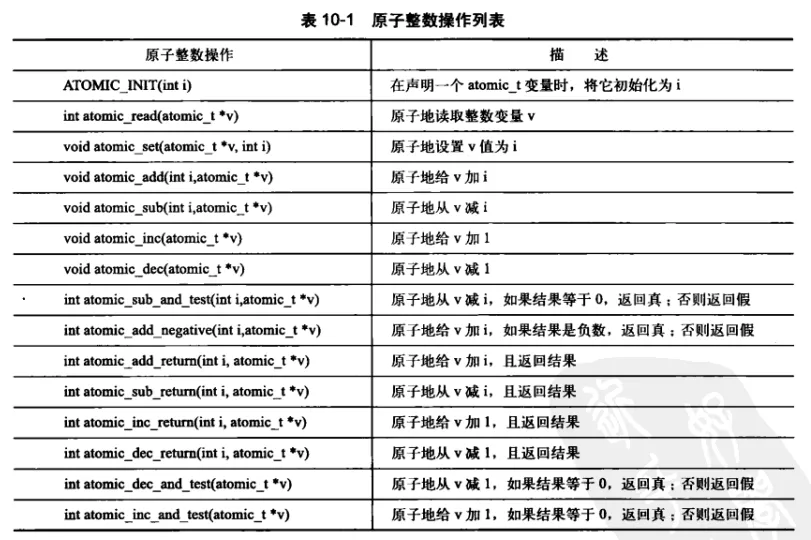
原子操作
- 为什么内核要专门发明一个 atomic_t 结构体,而不直接用 C 语言的 int? 平时写 C/C++ 代码时,我们习惯直接用 int i = 0; i++;。但在内核并发环境下,普通的 int 是极其危险的。图片中给出了内核非要搞一个 atomic_t 的三大原因:
-
强制的类型隔离与安全检查: 如果用普通 int,开发者可能会不小心把这个变量传给普通的加减函数,导致非原子访问,引发数据竞态。定义成特殊的 atomic_t 结构体后,你只能通过内核专用的 API(比如 atomic_inc()、atomic_read())去操作它。C 语言的编译器会帮你做严格的类型检查,防止误用。
-
防止编译器过度优化(核心考点 volatile): 你看代码片段里的 volatile int counter;。volatile 关键字在这里至关重要。它警告编译器:“这个变量的值随时可能被其他 CPU 核心或硬件中断意外改变,绝对不要把它缓存到寄存器里”。这强制 CPU 每次读取或修改这个变量时,都必须老老实实地去访问真正的内存地址,确保拿到的是最新值。
-
屏蔽不同底层硬件架构的差异:这也是结构体封装的好处,不管底层硬件是怎么实现原子操作的,对外提供的 API 永远是一致的。
Atomic_t
其定义在<linux/types.h>中
typedef struct
{
  volatile int counter;
}atomic_t
其原子操作是源于修改这个数据结构的API会调用底层的硬件API来保证这个操作是原子的
原子位操作
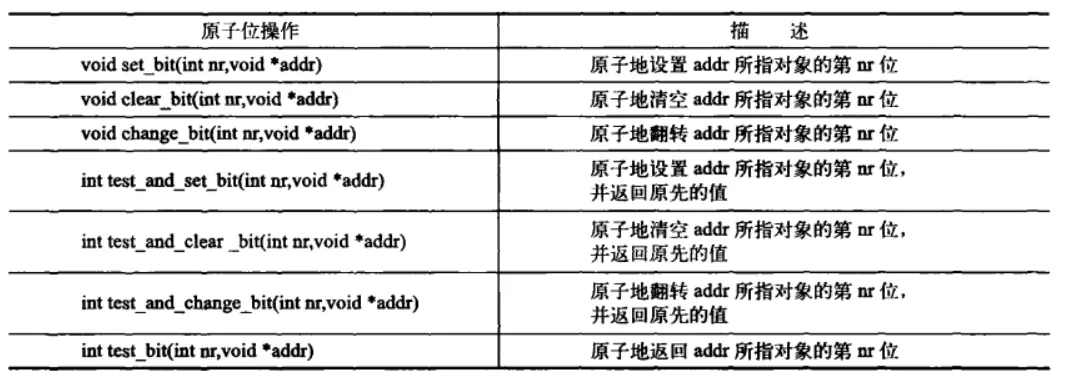
当你要对一个正常数据进行位操作时,你希望这个操作时原子性的就要用到原子位操作,相关的文件定义在<asm/bitops.h>中
就是说使用普通的变量,但是像set_bit这种api他是可以保证这个操作具有原子性
自旋锁
需要对保证一系列的动作都是原子的,而不是单单修改变量是原子的,这就要用到锁的操作
自旋锁就是最常见的锁,一个自旋锁最多只能被一个线程持有,当另一个线程想要获取这个锁时,就是等待当持有自旋锁的线程结束,才能获取到锁
在linux中,自旋锁的定义在<asm/spinlock.h>和<linux/spinlock.h>中,使用方式如下:
DEFINE_SPINLOCK(mr_lock);
spin_lock(&mr_lock)
/*··········*/
spin_unlock(&mr_lock);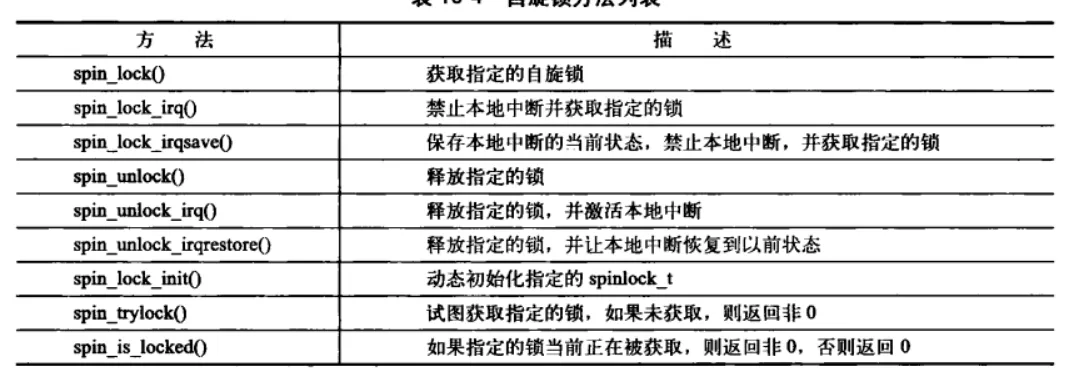
读写自旋锁
当一段临界区的数据需要被多个线程读取,却很少修改时,如果给他加上自旋锁,就会导致多线程读取数据变成串行的,导致性能下降,为了解决这一问题,读写自旋锁就应运而生了
机制
- 多个读进程可以同时获取到这个锁
- 写进程需要等待到锁是否时才能获取到这个锁
底层实现
- 锁为空闲的时候lock_count=0,当读线程加锁的时候,lock_count++,解锁的时候lock_count—
- 写线程加锁的时候只能等到lock_count=0才能加
使用方法
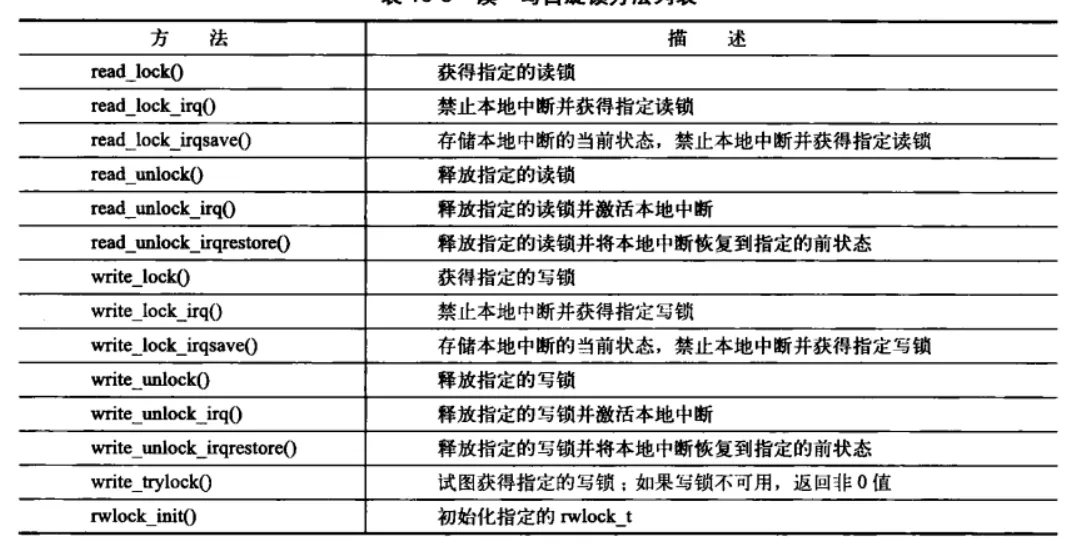
DEFINE_RWLOCK(mr_rwlock);

read_lock(&mr_rwlock);

read_unlock(&mr_rwlock);

write_lock(&mr_rwlock);
write_unlock(&mr_rwlock);
常见API
信号量
自旋锁是站着干等,不休息,而信号量就是拿号排队,没号休息等待通知
信号量内部维护着一个可用资源的数量(假设为 S)。对信号量的操作只能通过两个原语(不可分割的原子操作)来进行,通常被称为 P 操作(等待/获取)和 V 操作(发送/释放):
-
P 操作(Wait / Down):申请资源
-
线程尝试将信号量 S 减 1。
-
如果减 1 后 S >= 0,说明还有资源,线程直接拿走资源,继续向下执行。
-
如果减 1 后 S < 0,说明资源已经被拿光了。此时,系统会强行把这个线程挂起(让出 CPU,进入睡眠状态),并把它放进这个信号量的等待队列中。
-
-
V 操作(Signal / Up):释放资源
-
线程将信号量 S 加 1。
-
如果加 1 后 S <= 0(说明等待队列里还有人),系统会从等待队列中唤醒一个睡眠的线程,让它获得资源并继续执行。
-
如果加 1 后 S > 0,说明没人排队,仅仅是可用资源变多了而已。
-
计数信号量
初始值大于 1。它允许多个线程同时进入临界区,只要不超过资源总数
二值信号量
初始值设为 1。它的状态只能是 0 或 1,功能上非常类似于互斥锁(Mutex)。一次只允许一个线程访问临界区。
信号量的操作
文件在<asm/semaphore.h>中
- 初始化
struct semaphore name;
sema_init(&name,count);

static DECLARE_MUXTEX(name)l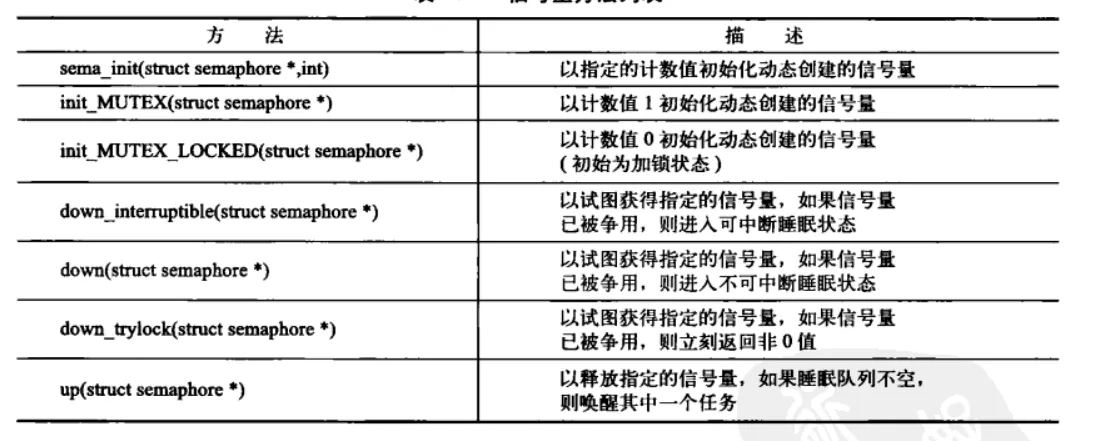
读写信号量
定义在<linux/rwsem.h>
和读写自旋锁类似,持有读锁的线程不限,但是持有写锁的线程只能有一个
static DECLARE_RWSEM(mr_rwsem)l
down_read(&mr_rwsem);

up_read(&mr_rwsem);

down_write(&mr_rwsem);

up_write(&mr_sem);
互斥体
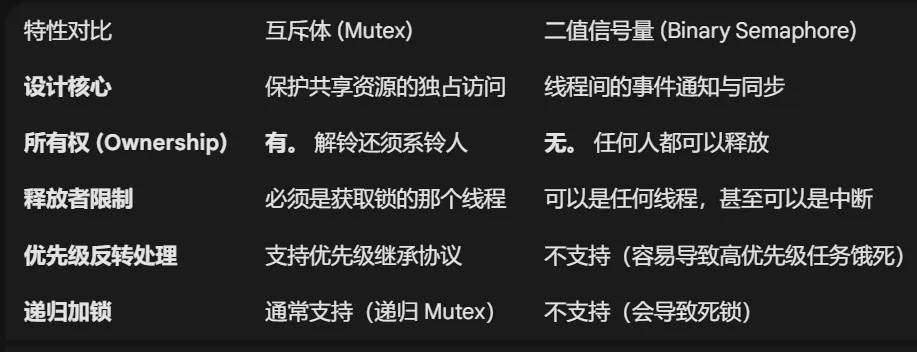
互斥体和二值信号量类似都是只允许一个线程进入临界区,但是互斥体拥有严格的所有权,哪个线程加的锁就必须由对应的线程解锁,二值信号量则任何线程都可以释放
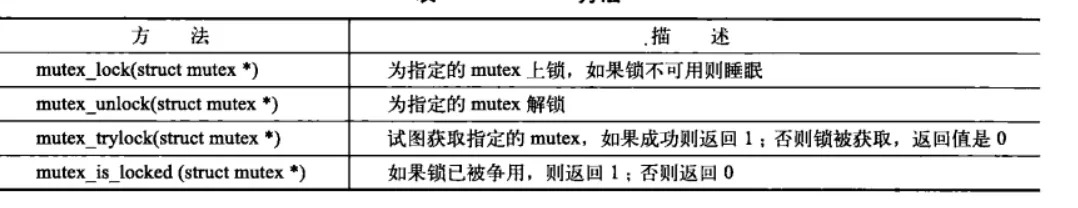
互斥体的对应API
在中断上下文中只能使用自旋锁
- 假设现在发生了一个硬件中断,CPU 停下手头的活,跑去执行中断处理函数。如果这个时候,代码里用了一个互斥体(Mutex)去锁某个数据,但没抢到锁。按照互斥体的规矩,拿不到锁就得去“睡觉”,也就是调用底层的 schedule() 函数让出 CPU.
在任务睡眠时只能使用互斥体
-
在底层系统中,当你调用 spin_lock() 成功拿到锁的那一瞬间,内核悄悄做了一件极其霸道的事情:它把当前 CPU 核心的“任务调度/抢占机制”给关了。只要你拿着这个锁,这个 CPU 核心就归你独占了,操作系统的调度器(HR 部门)无权强行把你踢下去换别人运行。
-
假设线程A拿到自旋锁,且休眠了,使得线程B运行,当线程B想要拿到线程A的自旋锁时,就会导致死锁
完成量
完成变量用于一个线程发出信号通知另一个线程发生了某件事。类似于信号量
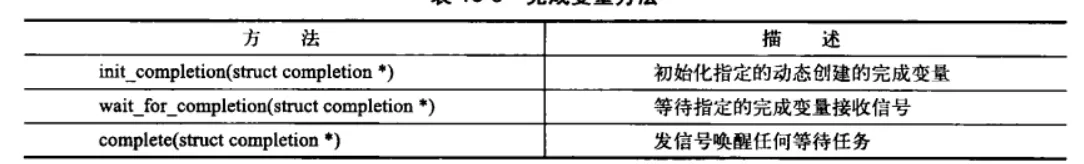
顺序锁
在读写自旋锁中,有一个致命的问题就是“写者饥饿”,如果有源源不断的读者进来,那么写者就拿不到锁
为了解决这一问题,linux内核就引入了顺序锁也叫seq锁,它巧妙地引入了一个递增的整型序列号(Sequence Counter)
- 写者要想修改数据,完全不需要理会现在有没有读者在读。只要没有其他写者在竞争(写者之间还是需要用一个小自旋锁互斥的),它就可以直接闯进去,把序列号变成奇数,大刀阔斧地修改数据,改完再把序列号变成偶数。
- 读者在序列号是奇数的时候不能读,读者在序列号为偶数的时候可以读,若读之前与读之后的序列号不同,则需要再读一遍