内核的内存管理
嵌入式学习打卡day2
页表
操作系统和 MMU 使用页表(Page Table)作为‘地址翻译字典’。它的映射单位是固定大小的内存块(通常是 4KB 的 Page)。为了节省物理内存,现代操作系统的页表本身并不是一片巨大的连续内存,而是采用‘多级树状结构’(多级页表),像多级目录一样按需分配、分散存储在物理内存中。
- 页表是虚拟地址到物理地址的映射目录,它负责“欺骗”进程,让进程以为自己拥有一段连续的内存,而实际上底层对应的物理内存往往是碎片化、不连续的。
- 映射不是逐字节进行的,而是以“页(Page)”为基本单位。比如,虚拟地址里的某一个 4KB 页面(假设是 0x0000 到 0x0FFF),会被 MMU 整体打包映射到物理内存的另一个 4KB 页面上,而这 4KB 内部的具体偏移量(Offset)在转换前后完全一致。
- 页表自身绝对不是一个连续的一维大数组,而是多级树状结构。以 Linux 和 ARM64 架构为例,它通常被拆分为多级(如 PGD -> PUD -> PMD -> PTE)。只有最顶层的“全局页目录”(PGD)占用一页连续内存,底层的页表项都是进程实际用到哪块内存,才去动态分配哪块的页表,它们散落在物理内存的各个角落,靠指针串联。
在内核中使用struct page来描述一个物理页,定义在<linux/mm_types.h>,以下是简化版
struct page{
    unsigned long flags; //存放该页的状态标志。具体状态定义在<linux/page-flags.h>
    atomic_t _count;  //记录页被使用的次数
    atomic_t _mapcount; //映射计数。 记录有多少个页表项(PTE)指向这个物理页。
    unsigned long private;//私有数据指针。这个字段的具体含义取决于这个页被用来干什么
    struct address_space *mapping;//如果这个物理页用于缓存某个磁盘上的文件,mapping 会指向该文件对应的地址空间结构
    pgoff_t index;//index 记录了当前页在那个文件中的偏移量
    struct list_head lru;//
    void *virtual;//页的虚拟地址
}
区
为什么内核要划分“区(Zone)”? 根本原因是硬件的物理限制或历史遗留问题。内核本来想对所有的物理页一视同仁,随便抓一个页就能用。但是底层硬件不允许,主要表现为两个痛点:
- DMA 寻址限制: 有些老旧或特定的外设(比如老式的网卡、声卡),它们的 DMA(直接内存访问)控制器能力很弱,只能访问物理内存很靠前的一小段地址。如果你给它分配了高地址的内存,它根本找不到,数据就传不过去。
- 内核虚拟地址空间不足: 在 32 位系统中,内核自己的虚拟地址空间通常只有 1GB。如果你的机器插了 4GB 的物理内存,内核根本没办法把这 4GB 一次性全部永久映射到自己那可怜的 1GB 空间里。
四大核心区
ZONE_DMA/ZONE_DMA32(直接内存访问区): 这是最宝贵的内存区,专门留给那些有寻址缺陷的外设做 DMA 操作使用。书中提到的 x86 架构前 16MB 就是历史包袱的产物(为了兼容古老的 ISA 总线)。在处理底层设备驱动(如处理摄像头图像流或显示帧缓冲)时,经常需要明确要求从这里分配内存,以确保硬件能够顺利进行 DMA 搬运。ZONE_NORMAL(常规区): 这是最正常的、没有任何使用限制的物理内存。内核可以直接且永久地将这部分内存映射到自己的虚拟地址空间。系统的大部分内存分配都在这里进行。ZONE_HIGHMEM(高端内存区): 这就是刚才提到的 32 位系统的痛点。物理地址太高,超出了内核 1GB 虚拟地址的永久映射范围(通常是大于 896MB 的部分)。内核如果要用这部分物理页,就必须费劲地进行“临时映射”——找个空闲的虚拟地址,临时绑定一下,用完赶紧解绑。
由于 64 位系统拥有极其庞大的虚拟地址空间(比如 256TB),内核完全有能力把机器上所有的物理内存都永久映射进去。在现代 64 位架构下,ZONE_HIGHMEM 通常是空的(根本不存在)。所有的物理页除了少数留给 DMA 外,其余的全部属于自由自在的 ZONE_NORMAL。
页操作的核心函数
struct page *alloc_pages(gfp_t gfp, unsigned int order);- 分配个连续页,返回第一页的指针
unsigned long get_zeroed_page(gfp_t gfp_mask);- 将获取到的页分配为0
extern void free_pages(unsigned long addr, unsigned int order);- 释放页
void *kmalloc(size_t size, gfp_t flags)- 获取以字节为单位的内存
gfp_mask(Get Free Page mask)
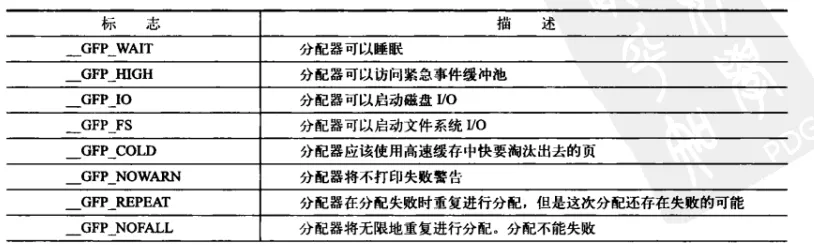
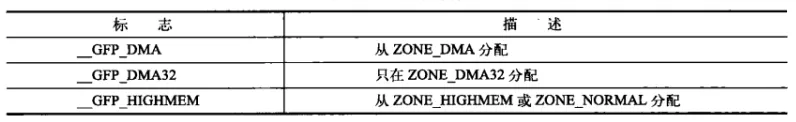
在 Linux 内核中,需要申请内存时,你不能只告诉内核“我要多大”的内存,你还必须通过 gfp_mask 告诉内核“你要怎么帮我找这块内存”以及“去哪里找”
- 行为修饰符(Action Modifiers):决定“怎么找”
-
区修饰符(Zone Modifiers):决定“去哪找”
-
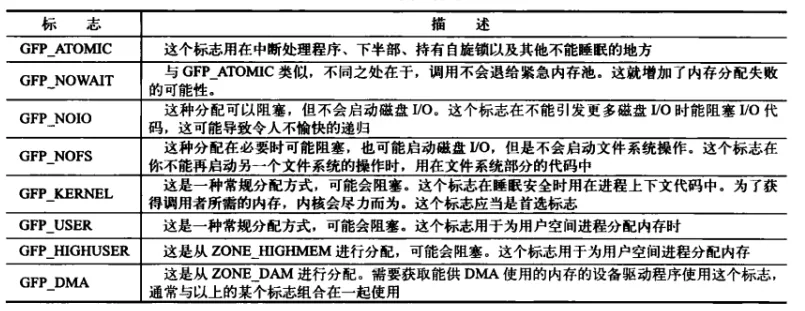
类型标志(Type Flags):开发者的“快捷套餐” 每次分配内存都要把行为修饰符和区修饰符一个一个通过按位或(|)组合起来,那太容易写错代码了。因此,内核将各种可能用到的组合归纳为不同类型,简化了修饰符的使用。这样,你只需指定一个类型标志就可以了。
slab层
我们在写底层代码时,经常会遇到需要频繁创建和销毁特定数据结构的情况,内核是如何高效处理这种“小块内存”分配的
- 为什么需要 Slab 分配器?
- 在引入 slab 之前,程序员为了避免频繁分配和释放小块内存带来的性能损耗,常常会自己维护一个空闲链表,把已经分配好的数据结构块缓存起来。代码需要用时,就从链表里抓取一个;用完后,不把它真正退还给系统,而是放回空闲链表里备用。这就相当于一个对象高速缓存。
- 致命缺陷: 当系统可用内存变得极度紧缺时,内核急需回收内存,但它根本不知道这些分散在各个驱动或模块里的私有空闲链表的存在。内核无法通知它们收缩缓存来释放内存
为了解决这一问题,linux 引入了 slab 分配器,来扮演通用数据结构缓存层的角色。
Slab 分配器的设计哲学
-
防碎片与快复用: 频繁分配和回收必然会导致内存碎片(找不到大块连续可用内存)。Slab 会把数据结构的缓存连续地存放,回收的对象被放回后不会导致碎片。同时,回收的对象可以立即投入下一次分配,极大地提高了性能。
-
多核(SMP)无锁优化: 在多核处理器上,如果多个 CPU 同时去同一个池子里拿内存,就需要加锁,这会严重拖慢速度。Slab 可以让部分缓存专属于单个处理器,这样分配和释放就可以在不加 SMP 锁的情况下独立进行。
-
硬件缓存亲和性(着色/Coloring): 这是极具硬件思维的一点。Slab 会对存放的对象进行“着色”(微调它们在物理页内的偏移量),防止多个高频使用的对象在 CPU 硬件高速缓存(L1/L2 Cache)中映射到同一个缓存行(Cache Line)而互相踢出。
-
NUMA 感知: 如果系统是 NUMA 架构,分配器可以聪明地从请求者所在的相同内存节点进行分配,减少跨节点访问的延迟。
- UMA(Uniform Memory Access),CPU 核心都共享同一个大内存,
- NUMA(Non-Uniform Memory Access),CPU 和内存进行了分组(Node/节点),CPU 0 访问自己 Node 0 的本地内存非常快,访问远程内存会有延迟惩罚
slab的架构
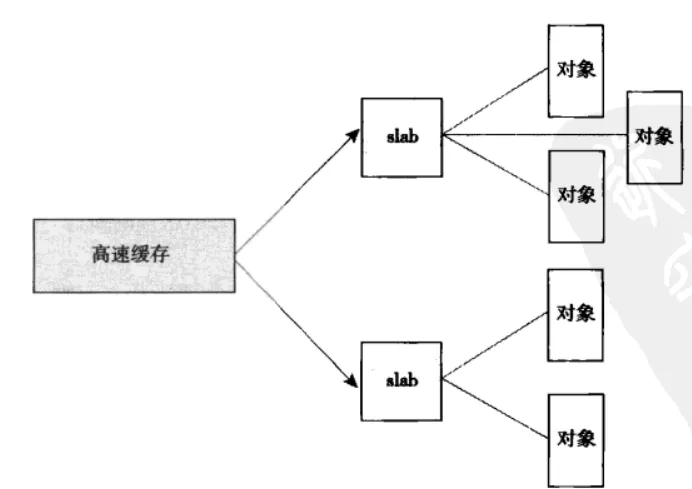
- 内核不会把所有的东西混在一起。slab 层把不同的对象划分为了不同的高速缓存组,每种对象类型对应一个专属的高速缓存。
- 这些高速缓存被进一步划分为一个或多个 slab,slab会请求具体的页内存
- 每个 slab 里面包含着多个对象成员
思考:为什么需要第二层slab,特定的高速缓存存放对应的对象不行吗?
- 作为物理页和细碎对象之间的“批发转换器”
-
Slab 层的首要作用,就是出面去向底层系统申请一个或多个物理上连续的页。
-
申请到这块大内存后,Slab 会像切豆腐一样,把它精细地划分为一个个大小相等的格子(Object),供上层使用。它完美地屏蔽了底层按页分配的粗粒度。
- 实现内存的“成建制回收”(对抗内存碎片的核心)
- 这是 Slab 层存在的最关键原因。如果所有的 Object 都散落在 Cache 这个大池子里,当系统内存极度紧缺,需要回收内存时,内核会无从下手——它不知道哪些 Object 凑在一起刚好能拼成一个完整的物理页退还给系统。
-
Slab 本质上就是物理页的化身。
-
内核通过监控 Slab 的三种状态(满、部分满、空)来掌控全局。
-
当一个 Slab 里的所有对象都被释放,它的状态变成“空 (Empty)”时,内核立刻就知道:“哦!这个货架全空了,这代表它底层的那个 4KB 物理页现在是完整无缺的。
- 提供硬件级别的内存对齐与着色(Coloring) Slab 这一层除了划分对象,还负责在物理页内部做精密的“排版”。
-
它知道物理页的边界在哪里,因此可以保证里面的每一个 Object 在内存地址上是严格对齐的(比如按 8 字节或 16 字节对齐),这能让 CPU 的寻址速度达到最快。
-
它还能通过调整 Object 在 Slab 内的偏移量(也就是上一张截图提到的“着色”),防止不同 Slab 中的对象在 CPU 硬件 L1 缓存中发生冲突。
内核栈
普通应用程序在用户空间运行时,可以奢侈地使用非常大的栈,而且这个栈还可以根据需要动态增长。但是内核却没有这么奢侈。 内核为每个进程分配的栈是小而且固定的。这样做有两个好处: 大大减少了系统整体的内存消耗。 内核无需承担沉重的栈管理任务(比如动态扩容)
内核栈的大小
-
历史上,每个进程都有两页的内核栈。在 32 位(4KB 页)系统上是 8KB,在 64 位(8KB 页)系统上是 16KB。
-
单页栈(Single-page)的引入: 在 2.6 系列内核早期,引入了单页内核栈的设置。激活后,每个进程的栈就只有一页那么大(4KB 或 8KB)。
为什么要使用单页栈
非常底层的痛点:内存碎片。随着系统长时间运行,物理内存变得越来越碎片化,要想在内存里找到两个未分配的、连续的页会变得极其困难。如果找不到连续的两页,创建新进程就会失败或者严重卡顿。因此,改成单页栈极大缓解了内存分配器的压力。
内存分配函数的选择
- 场景一:日常开发的最优解(连续物理内存)
- 这是绝大多数情况下的首选。如果你需要连续的物理页,应该使用某个低级页分配器或者 kmalloc()。
-
硬核环境(不能睡): 如果你的代码在中断处理程序或其他不能睡眠的代码段中运行,必须使用 GFP_ATOMIC。它指示内核进行高优先级分配,即使找不到内存也绝对不能睡眠等待。
-
宽松环境(可以睡): 如果代码在普通的进程上下文(且没有持有自旋锁),应该使用 GFP_KERNEL。这允许内核在必要时睡眠去整理出空闲内存,分配成功率最高。
-
- 场景二:与高端内存打交道
- 如果你指明要从高端内存(ZONE_HIGHMEM)进行分配,必须使用底层的
alloc_pages() - 因为高端内存很可能没有被直接映射,所以这个函数只能返回一个代表物理页的 struct page 指针,而不是你能直接读写的逻辑地址。为了获得真正的 C 语言指针,你必须接着调用 kmap() 把这块内存映射到内核的逻辑地址空间里。
- 场景三:大内存的救星(只要虚拟连续即可)
- 如果你需要很大的一块内存,但只要求虚拟地址连续,不强求物理地址连续,那么就使用 vmalloc()。
- 原理: 它非常像用户空间的 malloc(),它会在物理内存中到处搜刮碎片化的页,然后通过修改内核页表,把它们在逻辑地址空间上拼装成连续的一大块。
- 场景四:专属数据结构的兵工厂(Slab)
- 如果你需要频繁地创建和撤销很多大的数据结构,就应该专门为它考虑建立 slab 高速缓存。Slab 层会给每个处理器维持一个对象高速缓存(空闲链表)。避免了每次都去底层频繁分配和释放.